EOCRC 실습 3: TCGA에서 8-gene 생존분석 재현하기
1. 무엇을 실습하나
섹션 제목: “1. 무엇을 실습하나”생존분석 표의 한 행은 환자 한 명입니다. 다음 세 종류의 열을 연결합니다.
| patient | ALDOB … WNT11 | time_days | event |
|---|---|---|---|
TCGA-XX-0001 | 종양의 8-gene expression | 1,240 | 1 |
TCGA-XX-0002 | 종양의 8-gene expression | 980 | 0 |
event=1은 추적 중 사망이 관찰됐다는 뜻입니다. event=0은 980일에 살아 있었다는 뜻이지, 그 뒤에도 계속 생존했다는 뜻은 아닙니다. 마지막으로 상태를 확인한 시점까지만 정보를 가진 검열된 관측치입니다.
이 실습의 질문은 다음과 같습니다.
TCGA-COAD 환자의 종양에서 측정한 8개 유전자 발현을 하나의 risk score로 합쳤을 때, 높은 score 그룹과 낮은 score 그룹의 전체 생존 곡선이 다른가?
2. 발현 표와 생존 표를 환자 단위로 연결한다
섹션 제목: “2. 발현 표와 생존 표를 환자 단위로 연결한다”원 논문은 TCGA-COAD 종양 발현량과 UCSC Xena의 생존정보를 사용했습니다. 현재 GDC 자료는 처리 파이프라인과 릴리스가 달라질 수 있으므로, 논문의 p-value를 그대로 맞추는 대신 데이터 출처와 전처리를 고정합니다.
1단계 프롬프트: TCGA-COAD 8-gene 발현과 생존정보 준비
EOCRC 실습 프로젝트 안에 tcga-survival 분석을 추가해줘.

1. uv add xenaPython lifelines를 실행하고 Python, pandas, lifelines 버전을 기록해.
2. UCSC Xena의 현재 GDC hub에서 TCGA-COAD.star_tpm.tsv와 TCGA-COAD.survival.tsv를 확인하고 hub URL, dataset 이름, 다운로드 날짜를 기록해.
3. ALDOB, FBXL16, IL1RN, MSLN, RAC3, SLC38A11, WNT11과 WBSCR27의 현재 이름인 METTL27만 expression matrix에서 조회해. 출력 열에서는 METTL27을 WBSCR27로 표시하고 alias 매핑을 기록해.
4. sample barcode의 앞 12자를 patient barcode로 사용하고 Primary Tumor sample type만 유지해. 한 환자에게 종양 sample이 여러 개면 가장 작은 sample barcode 하나를 선택해.
5. survival 표의 OS를 event, OS.time을 time_days로 사용하고 정의를 source manifest에 기록해.
6. time_days가 0 이하이거나 없거나 8개 발현 중 결측이 있는 환자는 제외하되 단계별 제외 수를 출력해.
7. 행은 환자, 열은 8-gene STAR-TPM expression, time_days, event가 되게 outputs/tcga-coad-8gene-survival.csv에 저장해.
8. 종양 sample 수, 고유 환자 수, 사망 event 수, 검열 수와 추적 기간의 중앙값을 출력해.
9. 현재 GDC STAR-TPM/Xena snapshot과 논문 분석 당시 자료가 같은 전처리와 릴리스라고 가정하지 말고 차이를 설명한 뒤 멈춰.
환자 수를 셀 때 RNA sample 수와 patient 수를 섞지 않습니다. 생존정보는 환자 단위이고 발현량은 sample 단위이므로, join 전에 한 환자당 하나의 종양 sample을 결정해야 합니다.
3. Cox model로 8개 값을 하나의 score로 합친다
섹션 제목: “3. Cox model로 8개 값을 하나의 score로 합친다”Cox proportional hazards model은 각 유전자의 발현량에 계수를 붙입니다. 환자 i의 score는 다음 형태입니다.
는 환자 i에서 유전자 j의 표준화된 발현량이고, 는 Cox model이 추정한 계수입니다. 양의 계수는 다른 변수가 같을 때 발현량이 높을수록 hazard가 높아지는 방향을 뜻합니다.
2단계 프롬프트: Cox score와 Kaplan–Meier curve
준비한 outputs/tcga-coad-8gene-survival.csv로 8-gene 생존분석을 추가해줘.

1. 8개 발현 열을 각각 평균 0, 표준편차 1로 표준화해. 평균과 표준편차를 outputs/tcga-expression-scaling.csv에 저장해.
2. lifelines CoxPHFitter로 time_days와 event를 사용한 8-gene Cox proportional hazards model을 적합해.
3. gene별 coef, exp(coef), 표준오차, p-value와 95% confidence interval을 outputs/tcga-cox-coefficients.csv에 저장해.
4. proportional hazards 가정을 점검하고 위반 신호를 outputs/tcga-ph-assumption.txt에 기록해. 경고를 숨기지 마.
5. 각 환자의 risk_score를 계산하고 중앙값 이상을 High, 미만을 Low로 분류해 outputs/tcga-risk-groups.csv에 저장해.
6. High와 Low의 Kaplan–Meier curve와 95% confidence interval, number at risk를 그려 outputs/tcga-8gene-km.png에 180 dpi로 저장해.
7. 두 그룹을 log-rank test로 비교하고 test statistic과 p-value를 기록해.
8. 원 논문의 전체 CRC 생존분석은 log-rank P=0.00013을 보고했지만 현재 값이 다르면 그대로 보고해. 데이터를 제거하거나 threshold를 바꿔 맞추지 마.
9. 같은 TCGA cohort에서 계수를 학습하고 같은 cohort에서 곡선을 평가했으므로 독립 검증이 아니라는 문장을 결과 요약에 포함해.
10. 이 분석이 EOCRC 환자만의 예후를 직접 검증한 것이 아님을 명시하고 한국어로 설명한 뒤 멈춰.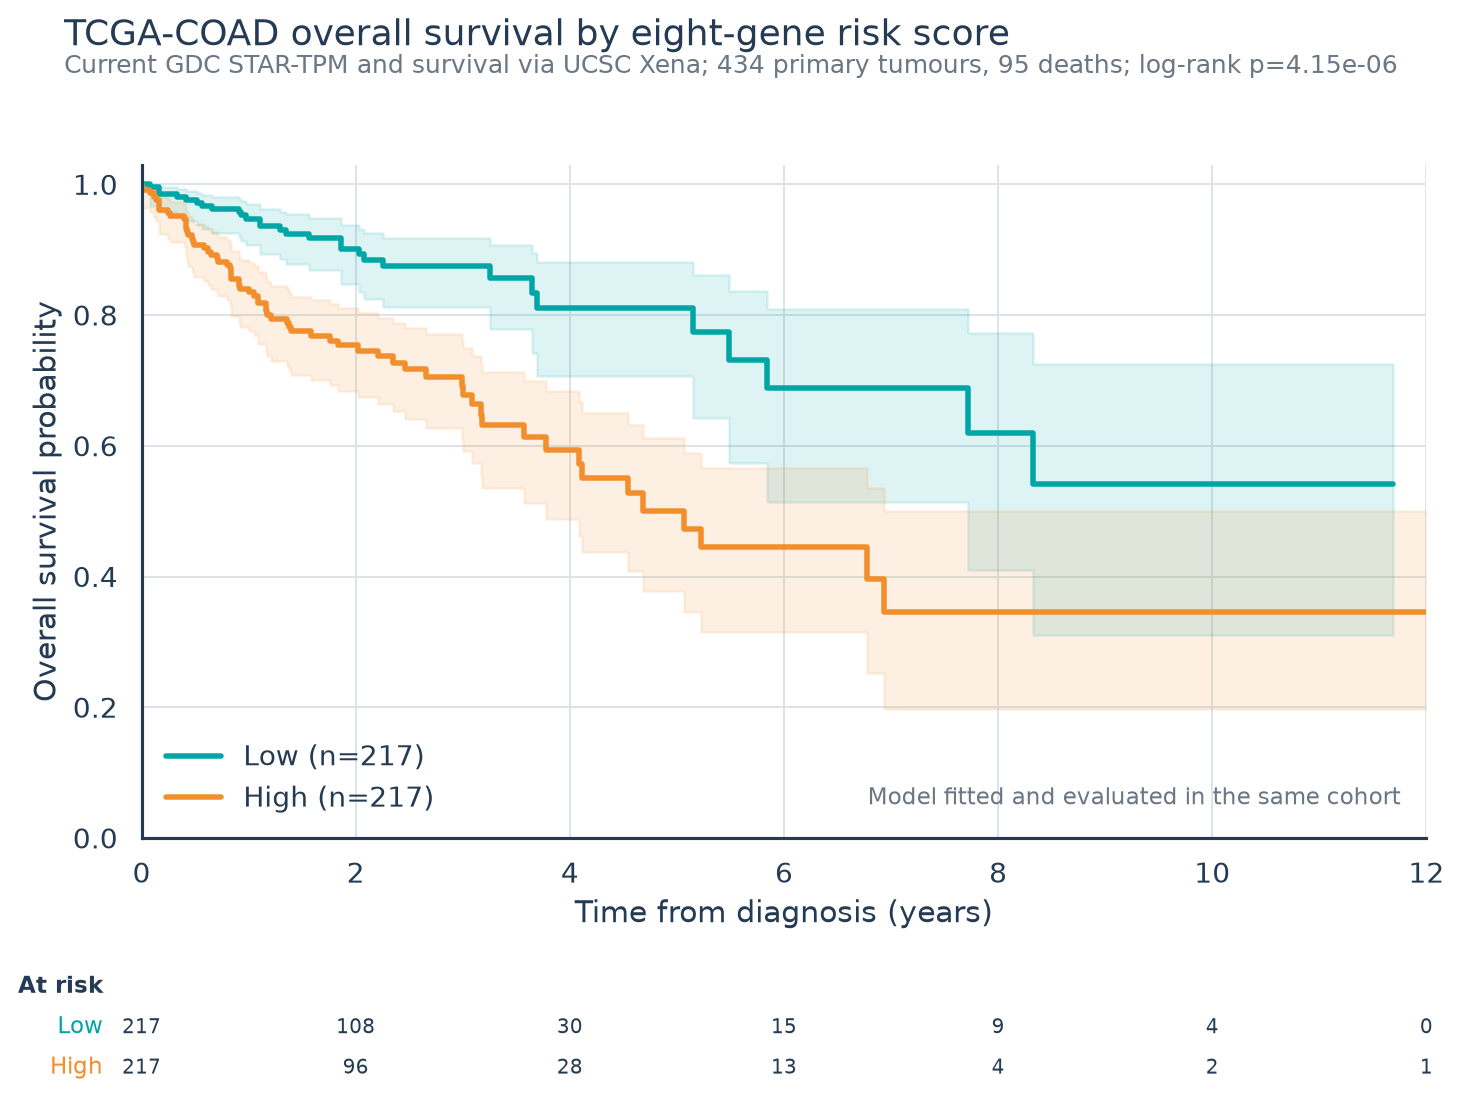
실제 실행 결과: 현재 GDC STAR-TPM과 UCSC Xena survival을 연결해 434명, 사망 event 95명을 분석했습니다. 같은 코호트에서 적합한 8-gene score를 중앙값으로 나눈 High·Low 그룹은 각각 217명이었고 log-rank p-value는 4.15 × 10⁻⁶이었습니다. 논문의 0.00013과 정확히 같지 않으며, 데이터 snapshot과 전처리가 다릅니다.
4. Kaplan–Meier curve를 읽는다
섹션 제목: “4. Kaplan–Meier curve를 읽는다”곡선의 세로축은 해당 시점까지 event 없이 생존할 추정 확률입니다. 가로축 뒤쪽으로 갈수록 추적 중인 환자가 줄어들므로, 곡선 끝부분의 큰 차이는 적은 환자에게서 만들어질 수 있습니다. number at risk를 곡선과 함께 확인하는 이유입니다.
log-rank p-value는 두 곡선이 같은지 평가하지만 효과 크기나 개인의 생존확률을 알려 주지 않습니다. Cox model의 hazard ratio도 특정 환자의 남은 생존일을 직접 예측하는 값이 아닙니다.
5. 결과를 보고 답할 질문
섹션 제목: “5. 결과를 보고 답할 질문”event=0인 환자의time_days는 무엇을 뜻하는가?- sample barcode를 바로 생존 표에 join하면 환자가 중복될 수 있는 이유는 무엇인가?
- score를 중앙값으로 나누면 p-value가 유전자 자체의 효과를 뜻하지 않는 이유는 무엇인가?
- 전체 TCGA-COAD 결과를 EOCRC 특이 예후로 부를 수 없는 이유는 무엇인가?
- model 학습과 곡선 평가에 같은 환자를 사용하면 어떤 편향이 생기는가?
다음 EOCRC 실습 4에서는 입력을 gene expression 표에서 BAM·splice-junction 정보로 바꾸고 exon inclusion을 비교합니다.
6. 출처와 재현 정보
섹션 제목: “6. 출처와 재현 정보”재현 기록에는 GDC release, API 쿼리, sample 선택 규칙, survival time 정의, expression 단위, 표준화 방법, lifelines 버전, Cox 계수와 median threshold를 남깁니다.